上海证券交易所股票代码:603019
您可以同时关注中科曙光微信公众号
使用微信扫一扫即可登录! 查阅资料更方便、 快捷!

2025年1月
服务热线:400-810-0466

发布时间: 2026-09-11
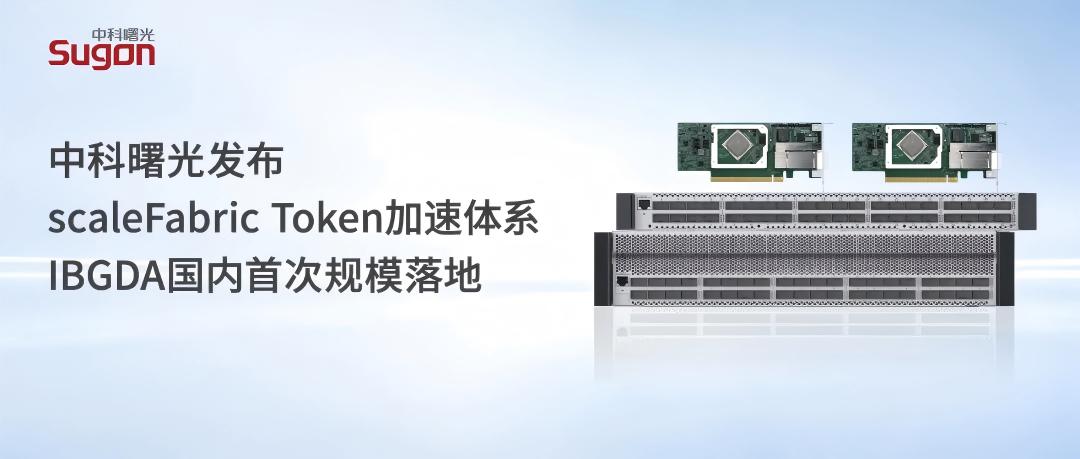
近日,中科曙光发布scaleFabric Token加速技术体系。该体系以scaleFabric原生无损RDMA高速网络为核心,通过计算、存储与网络协同,减少数据传输和读取过程中的等待,提升大模型运行效率。其中,支持GPU直接发起网络通信的IBGDA技术,已在十万卡级集群中完成验证,实现国内首次规模化落地。
Token是大模型处理和输出内容的基本单位,其生成效率直接影响模型响应速度与服务能力。从大模型训练到推理阶段,海量数据需要在多块GPU间传输、交换。如果通信调度慢、数据读取不及时,GPU就要停下来等待,影响Token产出效率,增加运行成本。
针对这些问题,中科曙光以scaleFabric原生无损RDMA网络为基础,打通计算、存储和传输环节,让数据更快到达、GPU少些等待,将更多算力用于实际计算。
在计算环节,GDR技术让网卡可直接读写GPU显存,减少CPU内存中转。IBGDA技术则进一步让GPU直接驱动网卡、管理数据传输,消除传统路径中CPU调度带来的开销,让计算与通信衔接更顺畅。
在存储环节,scaleFabric通过NVMe over RDMA、XDS和NFS over RDMA技术,加快远端存储访问,支持GPU直接读取远端数据,并提升文件传输效率,缩短数据从存储到计算的路径。
算存传的紧密协同,降低了数据经过多级交换设备时的传输时延。测试显示,其单跳转发时延低至260纳秒,端到端时延低于1微秒;在部分场景的三跳基准时延性能测试中,端到端时延较主流RoCE方案降低约63%,有效减少大规模集群中的通信等待,进而提升Token生成效率。
MoE(混合专家)模型需要将任务分配给不同“专家”处理,再汇总结果。这一过程会产生大量并发的小消息,通信调度效率直接影响模型运行速度。IBGDA让GPU直接发起通信,减少CPU在关键通信路径中的参与,提升多GPU之间的协同效率。
依托scaleFabric,中科曙光自研IBGDA技术已在十万卡级集群中完成验证。
目前,scaleFabric已完成与DeepEP等通信框架的适配,便于相关技术融入现有大模型应用环境。
从减少单次通信等待,到提升大规模集群协同效率,中科曙光持续推进计算、存储与网络优化,为国产AI基础设施提供更高效的系统支撑。




 400-810-0466
 Support@sugon.com
 津公网安备 12011602000521号


 注册 /